Dans une banque de financement, 25 modèles de machine learning tournaient en production. Personne ne les regardait.
Je ne dis pas ça pour pointer du doigt l'équipe. Elle avait fait le plus difficile : mettre ces modèles en service, ce que beaucoup d'organisations n'arrivent jamais à faire. Mais une fois déployés, plus rien ne mesurait leur performance. Et un modèle qu'on ne mesure plus finit toujours par se tromper sans que personne ne s'en rende compte.
En carrousel
Les slides du carrousel LinkedIn figurent ci-dessous.
Un portefeuille de modèles sans tableau de bord
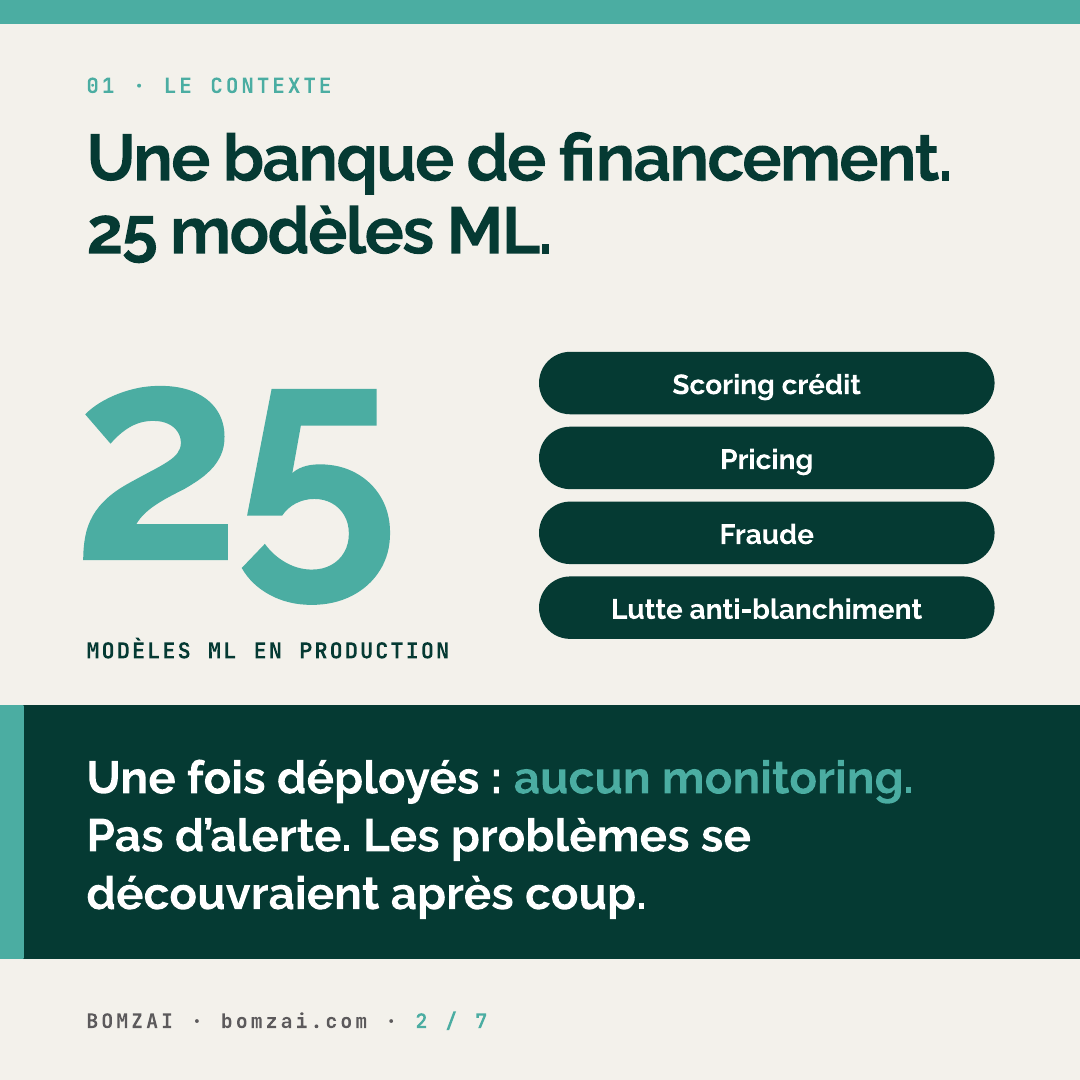
La banque comptait 3 000 employés. Ses 25 modèles couvraient des sujets sensibles : scoring crédit, pricing, fraude, lutte anti-blanchiment. Autrement dit, des décisions qui touchent directement au risque, au chiffre d'affaires et à la conformité.
Aucun de ces modèles n'avait de monitoring après son déploiement. Pas d'alerte automatique non plus. L'équipe MLOps découvrait les problèmes après coup, quand ils avaient déjà produit leurs effets.
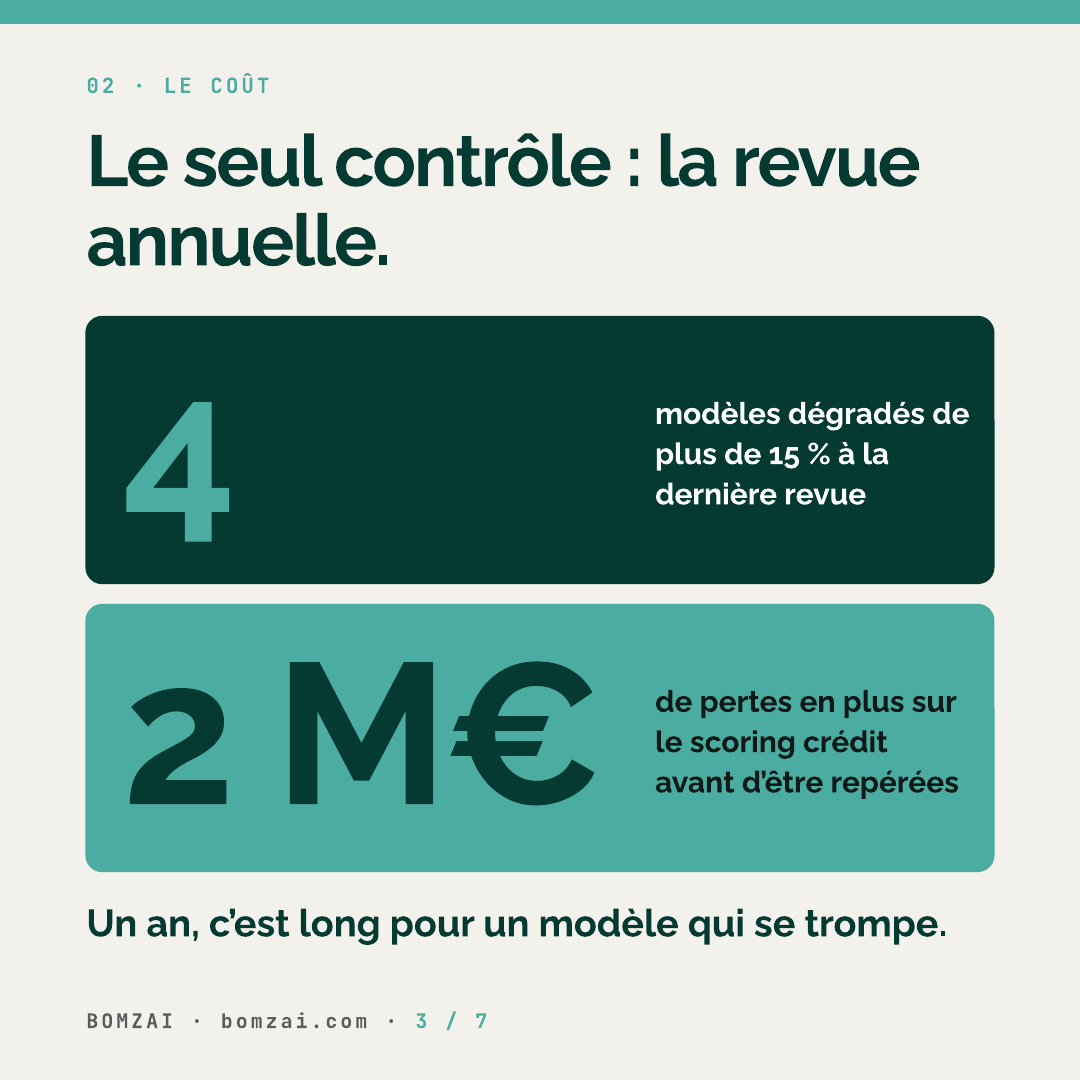
Le seul vrai point de contrôle, c'était la revue annuelle. Lors de la dernière, on a trouvé 4 modèles dégradés de plus de 15 %.
Pourquoi la revue annuelle ne suffit pas
Un an, c'est long pour un modèle qui se trompe.
Sur le scoring crédit, la dérive a coûté 2 M€ de pertes supplémentaires avant d'être repérée. Le modèle continuait de rendre des scores, les décisions continuaient d'être prises, et rien dans l'exploitation quotidienne ne signalait que quelque chose n'allait pas.
La revue annuelle avait aussi un autre problème : son coût. Elle mobilisait 3 mois-homme par modèle. Avec 25 modèles, et un portefeuille qui grossissait, cette approche ne pouvait pas suivre. Plus la banque mettait de modèles en production, plus elle s'exposait, et plus le contrôle devenait cher.
Il y a enfin la question du régulateur. Des modèles de crédit ou de lutte anti-blanchiment qu'on ne surveille pas en continu, c'est un risque réglementaire. Il faut pouvoir montrer que les modèles sont suivis, et comment.
Un modèle ne casse pas, il glisse
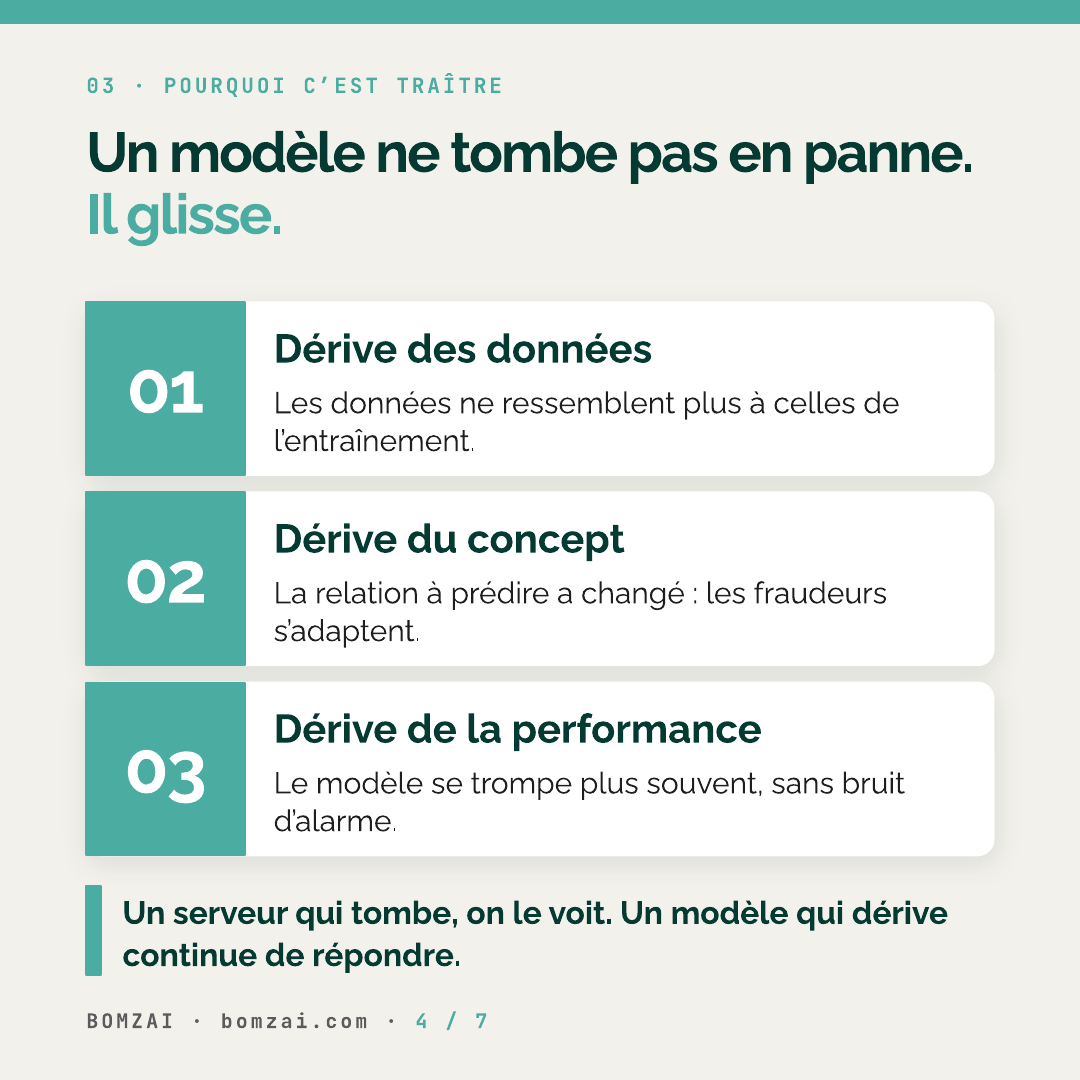
C'est ce qui rend la dérive si traîtresse. Un serveur qui tombe, tout le monde le voit dans la minute. Un modèle qui dérive continue de répondre, avec la même assurance, simplement de moins en moins juste.
On distingue en général trois formes de dérive, et on les a surveillées toutes les trois :
- la dérive des données : les données qui arrivent en production ne ressemblent plus à celles sur lesquelles le modèle a appris. La clientèle évolue, un produit change, une source est modifiée en amont ;
- la dérive du concept : la relation entre les données et ce qu'on cherche à prédire change. Les comportements de fraude en sont l'exemple typique, puisque les fraudeurs s'adaptent ;
- la dérive de la performance : au bout du compte, le modèle se trompe plus souvent qu'au moment de sa validation.
Aucune de ces dérives n'arrive d'un coup. Elles s'installent sur des semaines ou des mois. C'est justement pour ça qu'un contrôle une fois par an arrive trop tard.
Ce qu'on a mis en place
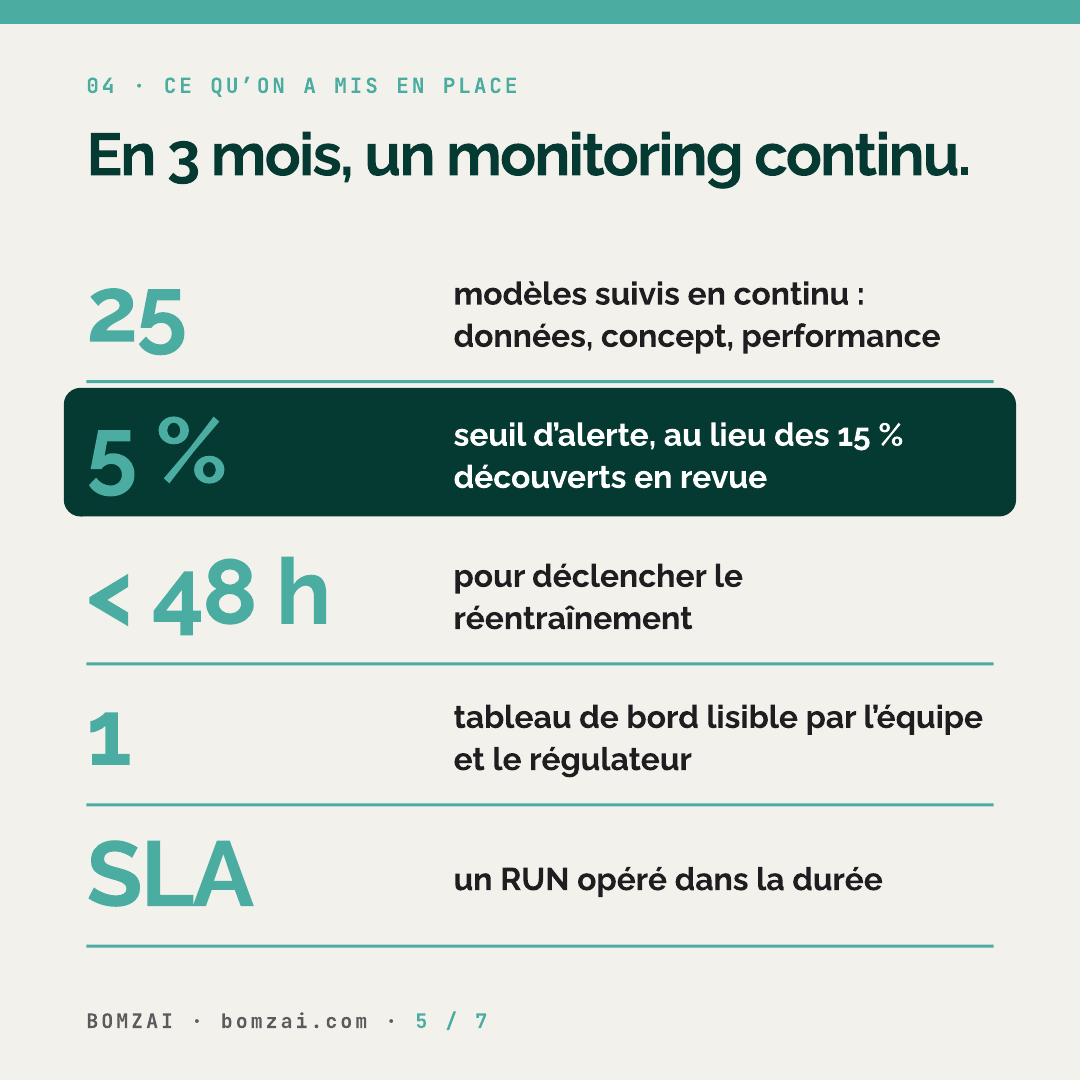
Le projet a duré 3 mois. L'objectif était simple à formuler : savoir, à tout moment, dans quel état est chacun des 25 modèles.
On a d'abord déployé une plateforme de monitoring en continu, construite avec MLflow et Evidently, sur Databricks, avec Grafana pour la visualisation. Elle surveille les trois formes de dérive sur l'ensemble du portefeuille, en temps réel.
Ensuite, on a fixé un seuil d'alerte. Dès qu'un modèle dérive de plus de 5 %, l'équipe est notifiée. On est loin des 15 % découverts à la revue annuelle : le problème remonte quand il est encore petit.
Troisième brique, le réentraînement. Quand une dérive est détectée, le réentraînement est déclenché automatiquement en moins de 48 h. La correction ne dépend plus de la disponibilité de quelqu'un pour s'en occuper.
Enfin, un tableau de bord centralisé montre la santé de chaque modèle. L'équipe le consulte au quotidien, et il est aussi lisible par le régulateur. Le monitoring est documenté et auditable, ce qui change complètement la conversation au moment des contrôles.
Et après la mise en service
Je crois que c'est le point le plus important de ce projet. Le système de monitoring n'a pas été livré puis laissé à lui-même. Il est opéré dans la durée, avec des SLA contractuels.
C'est cohérent avec ce qu'on défend chez Bomzai. Un système Data et IA ne s'arrête pas le jour où il entre en production. Les données changent, et les modèles finissent par dériver. Si personne n'est responsable de les suivre, on retombe tôt ou tard dans la situation de départ : des modèles en service que personne ne regarde.
Ce que je retiens de cette mission, c'est que le monitoring n'est pas un luxe qu'on ajoute quand tout le reste est fini. C'est ce qui permet de garder la valeur d'un modèle une fois qu'il est en production. Sans lui, chaque modèle déployé est un risque qu'on ne mesure pas.
Quelques questions à vous poser
Si vous avez des modèles en production, voici les questions que je poserais en premier :
- combien de modèles tournent aujourd'hui, et qui en a la liste à jour ?
- pour chacun, savez-vous comment il se comporte cette semaine, et pas seulement au moment de sa validation ?
- qui est prévenu, et sous quel délai, quand l'un d'eux commence à dériver ?
- combien de temps faut-il pour le réentraîner et le remettre en service ?
- pouvez-vous montrer tout ça à un auditeur ou au régulateur sans y passer des semaines ?
Si plusieurs réponses sont floues, vous n'êtes pas seul. C'est une situation que je rencontre souvent, y compris dans des équipes très solides techniquement.
Par où commencer
On ne demande à personne de tout reconstruire. En général, on commence par un audit ou une formation, pour faire l'inventaire des modèles en production et repérer ceux qui présentent le plus de risque. Ensuite vient un premier cas d'usage : le monitoring d'un premier lot de modèles, mis en production puis opéré en RUN, sous SLA. Le programme, qui étend le dispositif à tout le portefeuille, arrive quand ce premier lot a fait ses preuves.
On en parle ?
Si vous avez des modèles en production dont personne ne suit vraiment la performance, ou si votre seul contrôle reste une revue une fois par an, j'aimerais en discuter avec vous.
Écrivez-moi « DIAGNOSTIC » sur LinkedIn ou via la page contact du site. On prend 30 minutes pour regarder vos modèles et ce qu'il faudrait surveiller en premier.
Jean-Emmanuel ORFEVRE, fondateur de Bomzai