Num banco de financiamento, 25 modelos de machine learning rodavam em produção. Ninguém os acompanhava.
Não digo isso para apontar o dedo para a equipe. Ela tinha feito a parte mais difícil: colocar esses modelos em serviço, algo que muitas organizações nunca conseguem fazer. Mas, uma vez implantados, nada mais media o desempenho deles. E um modelo que a gente deixa de medir acaba sempre errando sem que ninguém perceba.
No carrossel
Os slides do carrossel do LinkedIn estão abaixo.
Uma carteira de modelos sem painel
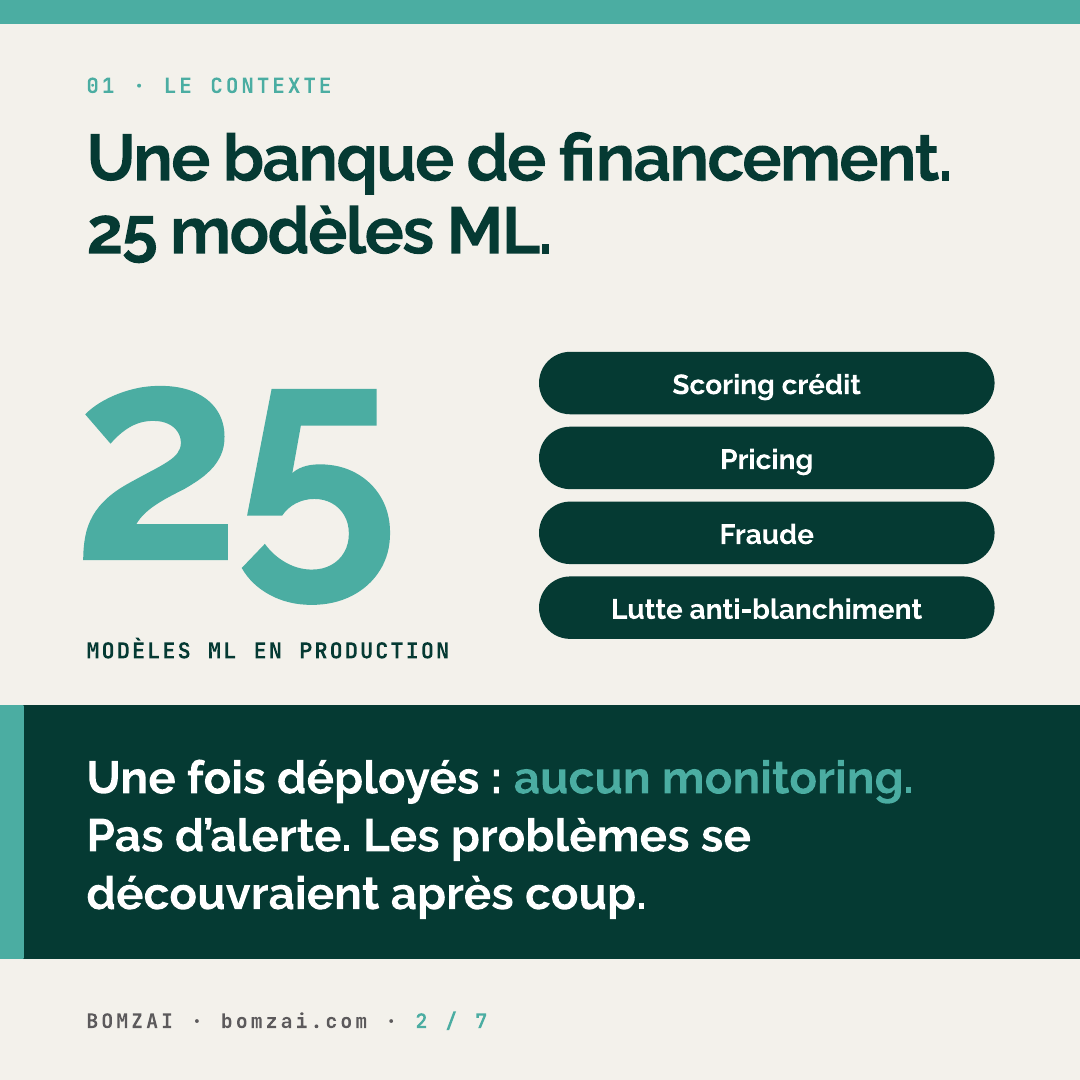
O banco tinha 3.000 funcionários. Seus 25 modelos cobriam temas sensíveis: scoring de crédito, pricing, fraude e combate à lavagem de dinheiro. Em outras palavras, decisões que tocam diretamente o risco, a receita e a conformidade.
Nenhum desses modelos tinha monitoramento depois da implantação. Também não havia alerta automático. A equipe de MLOps descobria os problemas depois, quando eles já tinham produzido efeito.
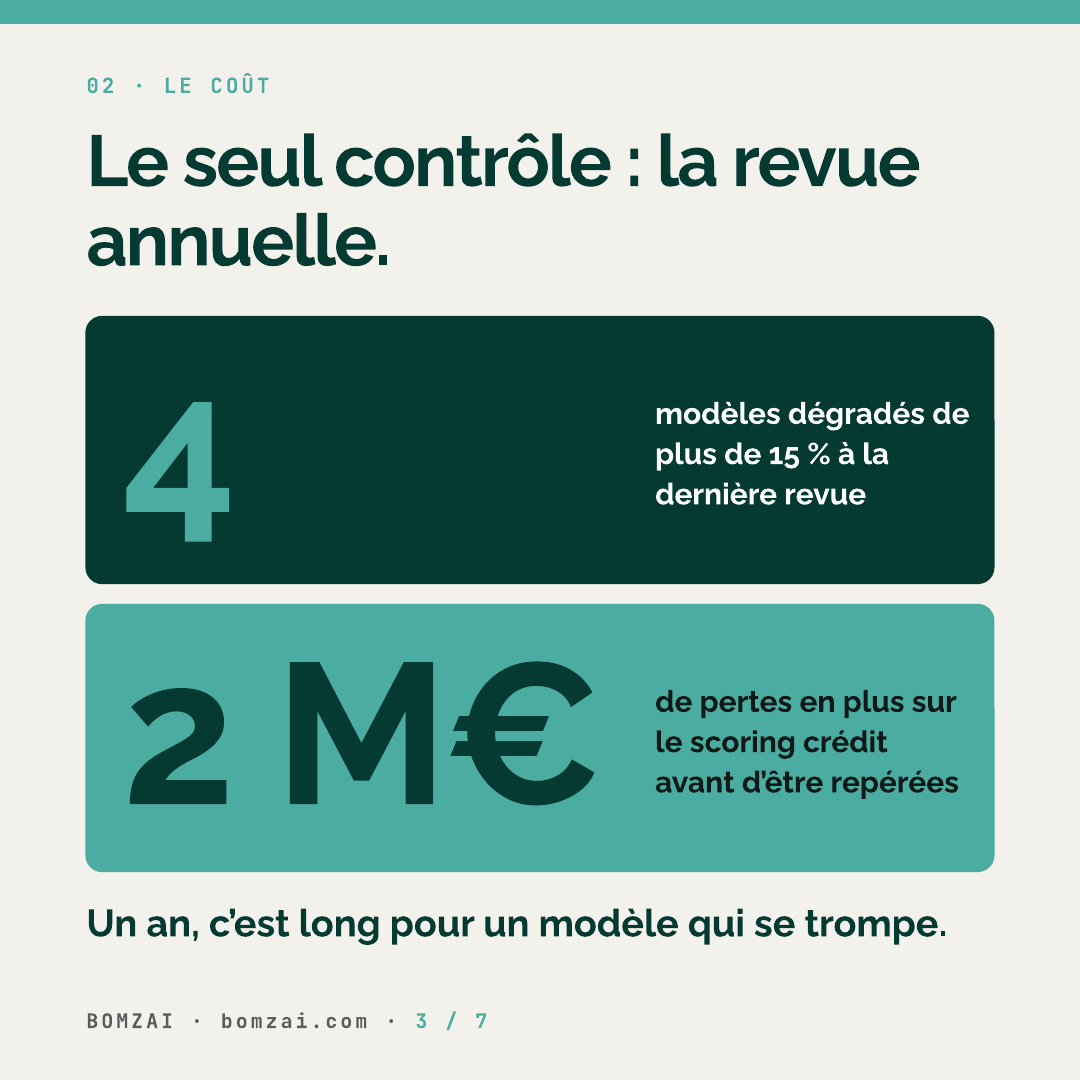
O único ponto de controle de verdade era a revisão anual. Na última, encontramos 4 modelos degradados em mais de 15%.
Por que a revisão anual não basta
Um ano é muito tempo para um modelo que está errando.
No scoring de crédito, a deriva custou 2 milhões de euros em perdas adicionais antes de ser percebida. O modelo continuava devolvendo scores, as decisões continuavam sendo tomadas, e nada na operação do dia a dia sinalizava que alguma coisa estava errada.
A revisão anual tinha outro problema: o custo. Ela consumia 3 homens-mês por modelo. Com 25 modelos, e uma carteira que crescia, essa abordagem não dava conta. Quanto mais modelos o banco colocava em produção, mais ele se expunha, e mais caro ficava o controle.
Há ainda a questão do regulador. Modelos de crédito ou de combate à lavagem de dinheiro que não são monitorados de forma contínua são um risco regulatório. É preciso conseguir mostrar que os modelos são acompanhados, e como.
Um modelo não quebra, ele escorrega
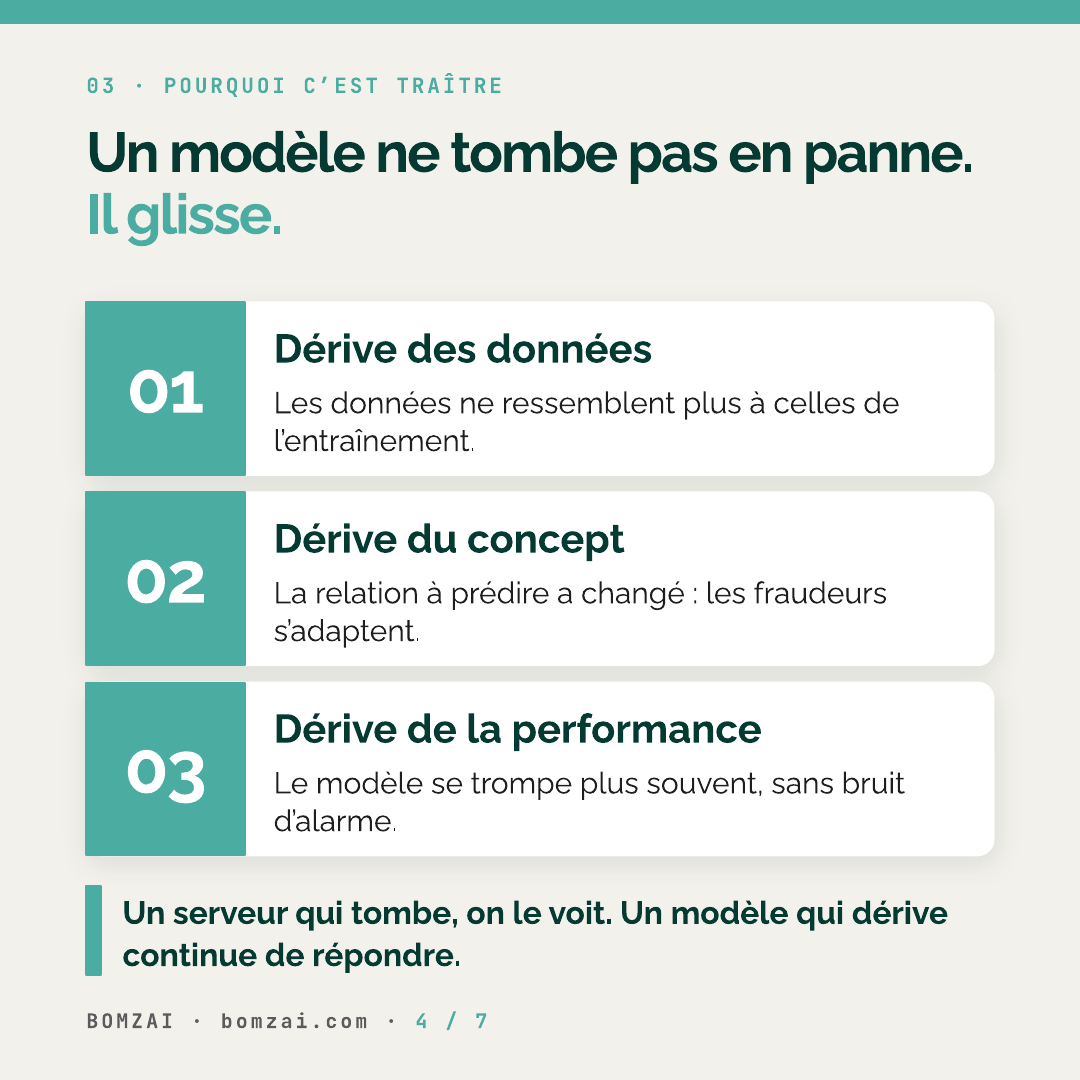
É isso que torna a deriva tão traiçoeira. Um servidor que cai, todo mundo vê em um minuto. Um modelo que deriva continua respondendo, com a mesma segurança, só que cada vez menos certo.
Em geral distinguimos três formas de deriva, e monitoramos as três:
- a deriva dos dados: os dados que chegam em produção não se parecem mais com aqueles com os quais o modelo aprendeu. A clientela muda, um produto muda, uma fonte é alterada na origem;
- a deriva de conceito: a relação entre os dados e o que se quer prever muda. O comportamento de fraude é o exemplo típico, porque os fraudadores se adaptam;
- a deriva de desempenho: no fim das contas, o modelo erra com mais frequência do que no momento da validação.
Nenhuma dessas derivas chega de uma vez. Elas se instalam ao longo de semanas ou meses. É justamente por isso que um controle uma vez por ano chega tarde demais.
O que colocamos em prática
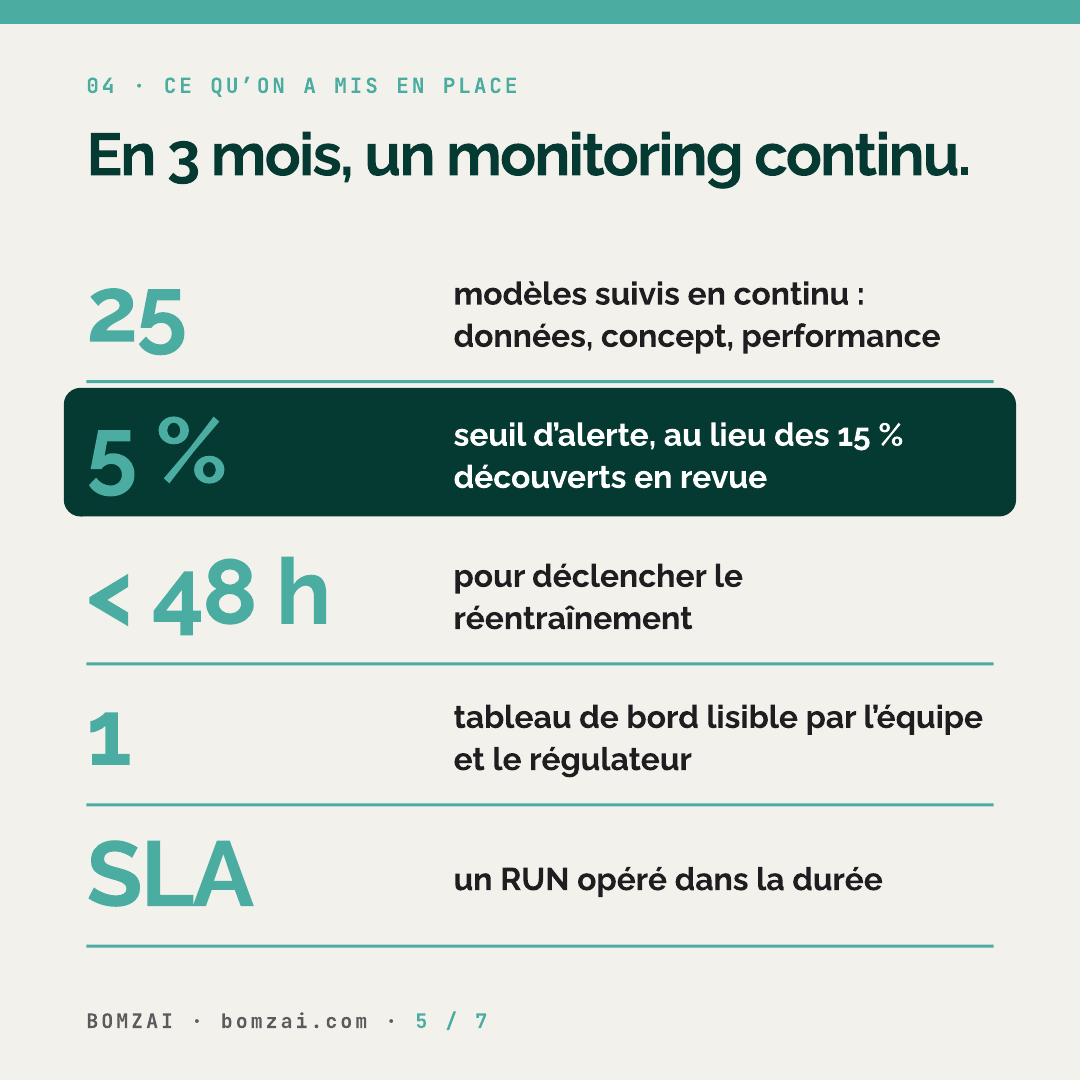
O projeto durou 3 meses. O objetivo era simples de formular: saber, a qualquer momento, em que estado está cada um dos 25 modelos.
Primeiro implantamos uma plataforma de monitoramento contínuo, construída com MLflow e Evidently, no Databricks, com o Grafana para a visualização. Ela acompanha as três formas de deriva em toda a carteira, em tempo real.
Em seguida, definimos um limiar de alerta. Assim que um modelo deriva mais de 5%, a equipe é avisada. Estamos longe dos 15% descobertos na revisão anual: o problema sobe enquanto ainda é pequeno.
A terceira peça é o retreinamento. Quando uma deriva é detectada, o retreinamento é disparado automaticamente em menos de 48 horas. A correção deixa de depender de alguém estar disponível para cuidar disso.
Por fim, um painel centralizado mostra a saúde de cada modelo. A equipe consulta no dia a dia, e ele também é legível para o regulador. O monitoramento é documentado e auditável, o que muda por completo a conversa na hora das fiscalizações.
E depois da entrada em serviço
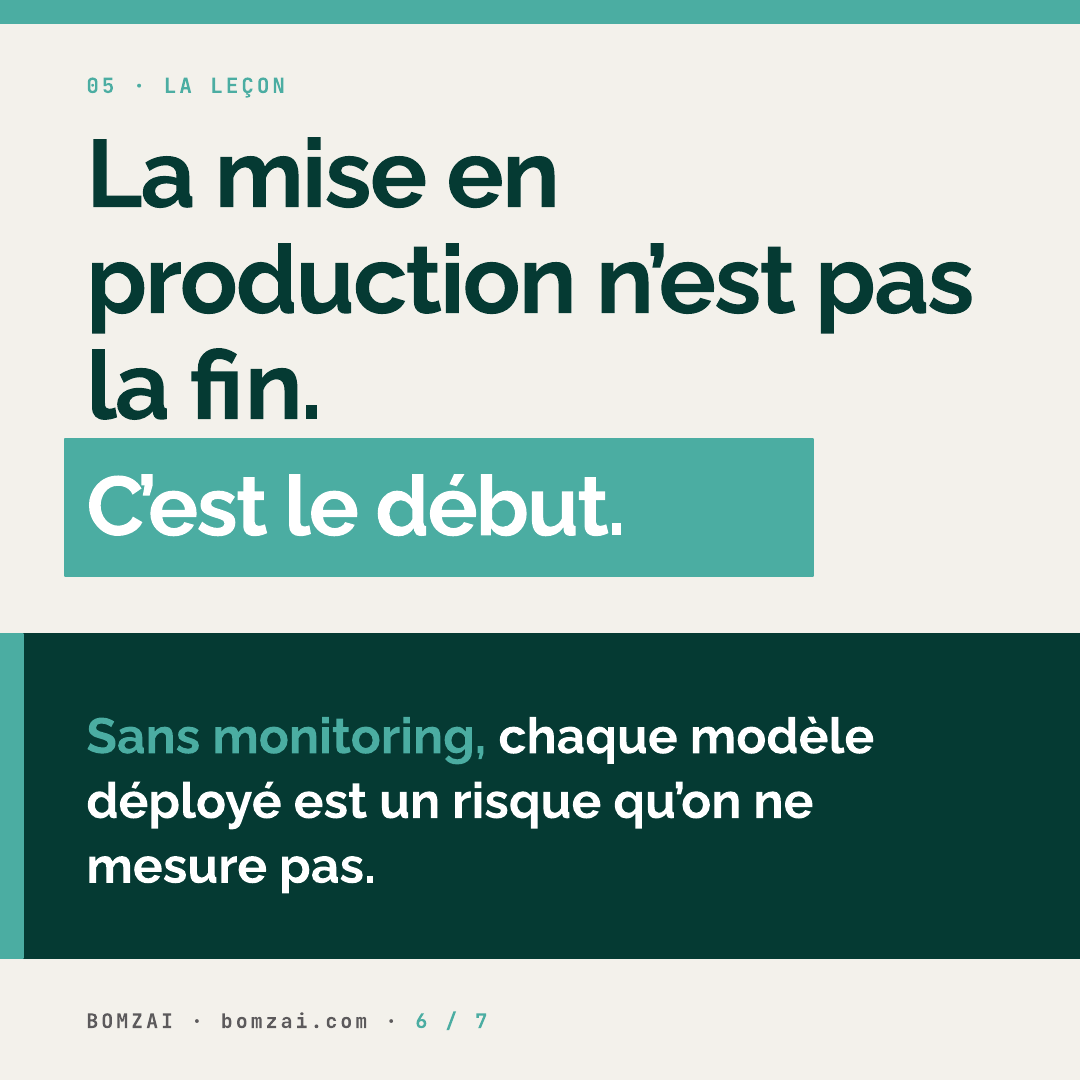
Acho que este é o ponto mais importante do projeto. O sistema de monitoramento não foi entregue e depois deixado por conta própria. Ele é operado no tempo, com SLAs contratuais.
Isso é coerente com o que defendemos na Bomzai. Um sistema de Data e IA não para no dia em que entra em produção. Os dados mudam, e os modelos acabam derivando. Se ninguém é responsável por acompanhá-los, mais cedo ou mais tarde voltamos à situação inicial: modelos em serviço que ninguém olha.
O que levo desta missão é que o monitoramento não é um luxo que se acrescenta quando todo o resto está pronto. É o que permite preservar o valor de um modelo depois que ele está em produção. Sem isso, cada modelo implantado é um risco que não se mede.
Algumas perguntas para se fazer
Se você tem modelos em produção, estas são as perguntas que eu faria primeiro:
- quantos modelos rodam hoje, e quem mantém a lista atualizada?
- para cada um, você sabe como ele se comporta nesta semana, e não só no momento da validação?
- quem é avisado, e em que prazo, quando um deles começa a derivar?
- quanto tempo leva para retreiná-lo e colocá-lo de novo em serviço?
- você consegue mostrar tudo isso a um auditor ou ao regulador sem passar semanas nisso?
Se várias respostas estiverem vagas, você não está sozinho. É uma situação que encontro com frequência, inclusive em equipes muito sólidas tecnicamente.
Por onde começar
Ninguém pede para reconstruir tudo. Em geral, começa-se por uma auditoria ou uma formação, para inventariar os modelos em produção e identificar os que apresentam mais risco. Depois vem um primeiro caso de uso: o monitoramento de um primeiro lote de modelos, colocado em produção e depois operado em RUN, sob SLA. O programa, que estende o dispositivo a toda a carteira, chega quando esse primeiro lote provou o que vale.
Conversamos?
Se você tem modelos em produção cujo desempenho ninguém acompanha de verdade, ou se o único controle ainda é uma revisão uma vez por ano, eu gostaria de conversar com você.
Escreva « DIAGNOSTIC » para mim no LinkedIn ou pela página de contato do site. Reservamos 30 minutos para olhar os seus modelos e o que deveria ser monitorado primeiro.
Jean-Emmanuel Orfèvre, fundador da Bomzai