O panorama da inteligência artificial aplicada à engenharia de software ultrapassou um marco histórico no primeiro trimestre de 2026. A época dos simples assistentes conversacionais capazes de gerar trechos de código isolados ficou definitivamente para trás, dando lugar a sistemas agênticos autônomos capazes de raciocinar sobre repositórios de código inteiros, planejar migrações complexas e colaborar em enxames de sub-agentes. Essa mutação tecnológica é impulsionada por uma concorrência direta entre os laboratórios americanos, liderados pela Anthropic e OpenAI, e os laboratórios chineses, como a Alibaba com o Qwen 3 e a Moonshot AI com o Kimi K2.5. Para uma organização técnica apoiada na infraestrutura AWS Bedrock, a escolha do modelo não se limita mais a uma simples comparação de precisão sintática, mas abrange agora dimensões de janela de contexto, protocolos de comunicação entre agentes (MCP) e eficiência de custo em escala industrial.
A emergência do Claude Opus 4.6: A supremacia do arquiteto cognitivo
Lançado em 5 de fevereiro de 2026, o Claude Opus 4.6 representa o ápice atual da hierarquia de modelos da Anthropic. Projetado para ser o modelo mais inteligente do mercado, ele se destaca por um foco acentuado em codificação agêntica, raciocínio profundo e, sobretudo, autocorreção. Essa iteração marca uma passagem da "ação" para a "ação sustentada", onde o modelo não se limita a responder a uma requisição, mas mantém uma coerência operacional por períodos prolongados.
Mecanismos da janela de contexto e combate à degradação
A inovação principal do Claude Opus 4.6 reside em sua janela de contexto de um milhão de tokens, atualmente em fase beta para os níveis de utilização elevados. Esse volume massivo permite ingerir o equivalente a 750.000 palavras ou diversas bibliotecas de software inteiras em uma única sessão. Mais crucialmente, a Anthropic parece ter resolvido o problema persistente da "deterioração do contexto" (context rot), onde o desempenho de um modelo se degrada à medida que a conversa se alonga. No benchmark MRCR v2, que testa a capacidade de recuperação de informações enterradas em vastos documentos, o Opus 4.6 atinge uma pontuação de 76% com oito agulhas escondidas em um milhão de tokens, enquanto seu predecessor Sonnet 4.5 alcançava apenas 18,5%.
Essa persistência contextual permite que os engenheiros realizem migrações de código que se estendem por milhões de linhas como se estivessem trabalhando com um engenheiro sênior dotado de uma memória perfeita da arquitetura global. O modelo é capaz de rastrear vazamentos de abstrações entre diversos serviços backend e manter as decisões de design coerentes do início ao fim da construção de uma aplicação.
Raciocínio adaptativo e controle de esforço
A transição para o modo "Adaptive Thinking" constitui uma ruptura com a abordagem binária dos modelos de 2025. O Claude Opus 4.6 agora analisa a complexidade de cada requisição para decidir dinamicamente o orçamento de raciocínio a alocar. O parâmetro de esforço associado propõe quatro níveis: baixo, médio, alto (padrão) e máximo. No modo de esforço máximo, o modelo revisita meticulosamente seu próprio raciocínio antes de produzir uma resposta, o que elimina muitos erros sutis que outros modelos deixam passar, mas ao custo de uma latência e um custo de tokens maiores. Essa flexibilidade permite utilizar o mesmo modelo para tarefas de refatoração simples (em modo médio) e para o debugging crítico de sistemas distribuídos (em modo máximo).

Qwen 3: A eficiência industrial e a otimização monorepo
O laboratório Alibaba posicionou o Qwen 3 como uma alternativa open-weight formidável, especificamente otimizada para ambientes de produção em grande escala no AWS Bedrock. Disponível em diversos tamanhos, desde o modelo denso de 32B até o flagship Mixture-of-Experts (MoE) de 480B, a série Qwen 3 aposta em uma arquitetura híbrida para conciliar potência de cálculo e economia de recursos.
A inovação Gated DeltaNet e a atenção linear
O sucesso técnico do Qwen 3, e particularmente de sua variante Qwen3-Coder-Next, se baseia na integração do Gated DeltaNet, um mecanismo de atenção linear com complexidade O(n). Essa arquitetura permite processar contextos longos sem sofrer a desaceleração quadrática típica dos modelos Transformers clássicos. Na prática, isso significa que o Qwen 3 pode analisar repositórios de código inteiros com uma velocidade de inferência superior, mantendo ao mesmo tempo uma atenção "global" necessária para compreender as relações entre arquivos distantes.
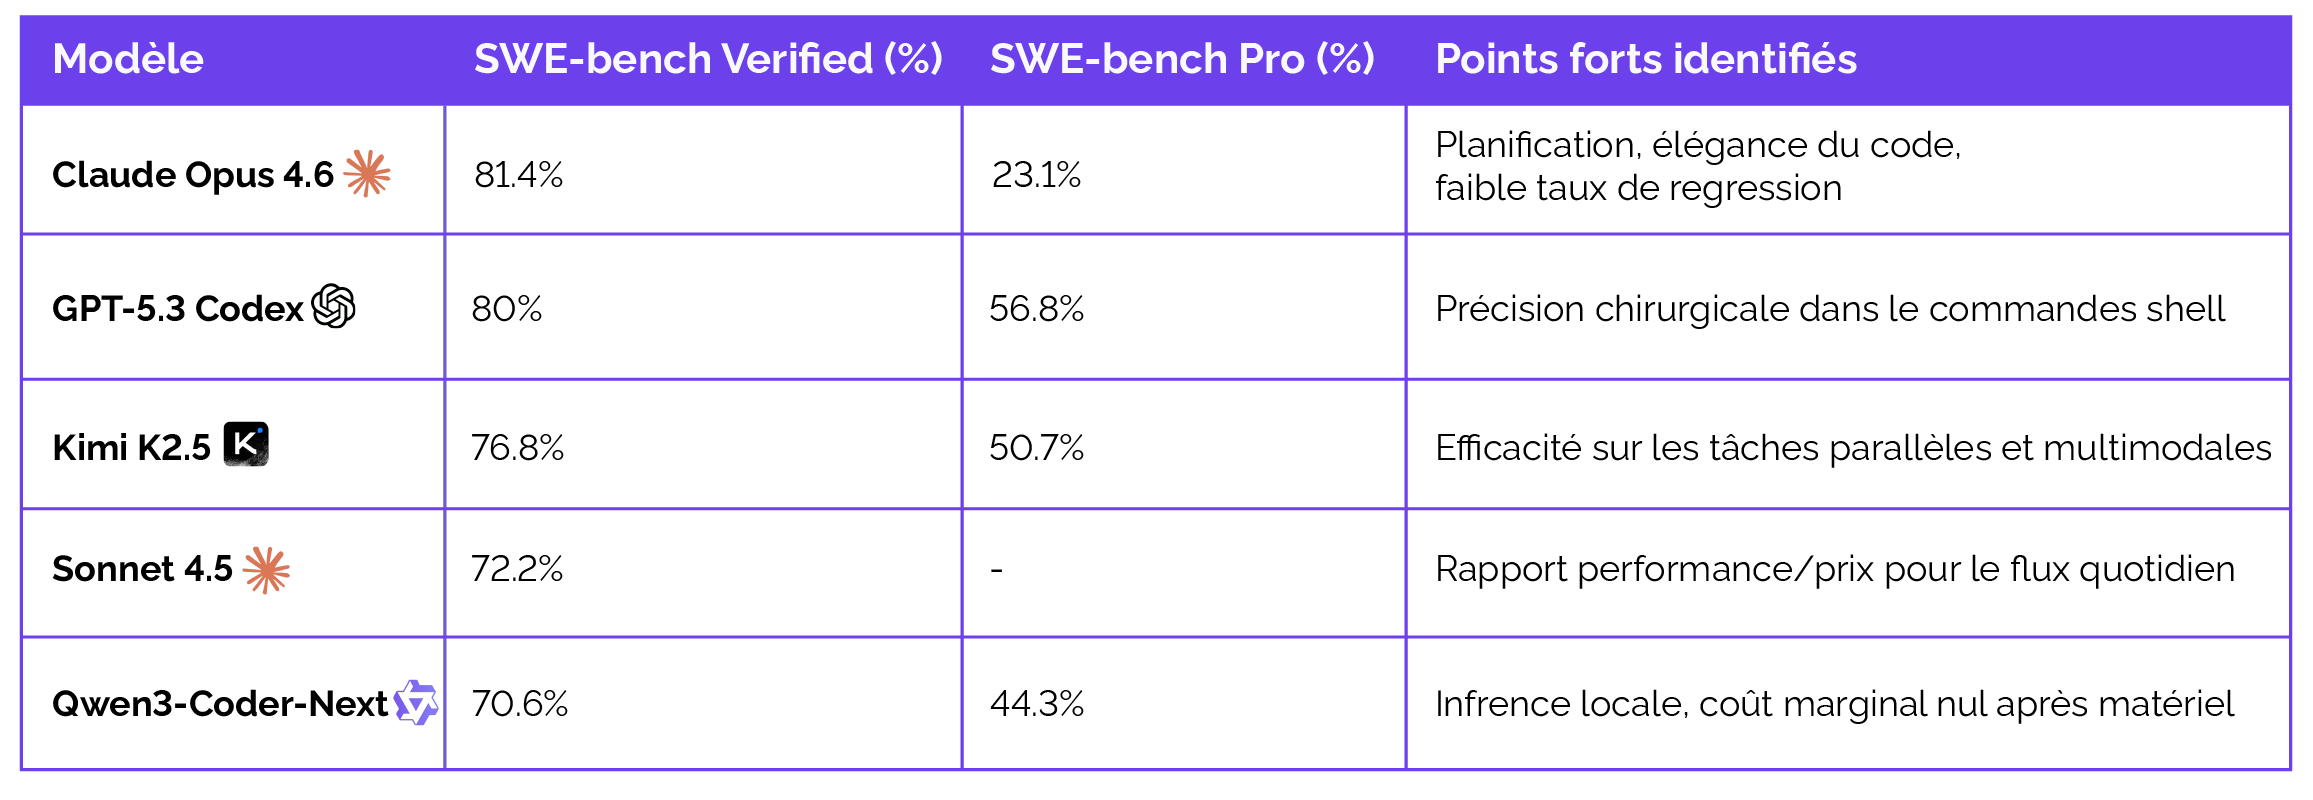
O modelo Qwen3-Coder-Next é um exemplo marcante dessa eficiência: com apenas 3 bilhões de parâmetros ativados por token, ele atinge desempenhos no SWE-bench Verified (cerca de 70%) comparáveis a modelos que ativam de 10 a 20 vezes mais parâmetros. Para uma empresa que utiliza o Bedrock, isso se traduz em uma redução drástica do custo total de propriedade (TCO) para agentes "sempre ligados" que monitoram os pipelines de CI/CD ou automatizam a manutenção preventiva.
Integração nativa no ecossistema Bedrock
A Alibaba trabalhou estreitamente com a AWS para garantir que o Qwen 3 estivesse disponível como serviço serverless gerenciado. Essa integração permite que os desenvolvedores acessem os modelos via uma API unificada, beneficiando-se da segurança de nível empresarial da AWS (IAM, VPC, PrivateLink) e do autoscaling sem gestão de infraestrutura. O Qwen 3 suporta nativamente o Model Context Protocol (MCP), o que facilita sua conexão com ferramentas de busca web, bancos de dados e interpretadores de código dentro do framework Bedrock AgentCore.
Kimi K2.5: O enxame de agentes e a inteligência visual nativa
A Moonshot AI, com o lançamento do Kimi K2.5 em janeiro de 2026, introduziu uma visão radicalmente descentralizada da assistência ao código. Esse modelo Mixture-of-Experts de 1040 bilhões de parâmetros (dos quais 32 bilhões ativos) é o primeiro a integrar nativamente a tecnologia "Agent Swarm".
A tecnologia Agent Swarm e o aprendizado PARL
Diferentemente das abordagens tradicionais onde um agente trata as tarefas de maneira sequencial, o Kimi K2.5 pode instanciar dinamicamente até 100 sub-agentes especializados trabalhando em paralelo. Esse sistema é pilotado por um orquestrador treinado via Parallel-Agent Reinforcement Learning (PARL), um método que ensina ao modelo como decompor requisições complexas em subtarefas independentes.
A eficiência do enxame é medida pela métrica dos "Passos Críticos" (Critical Steps), inspirada na computação paralela, que otimiza a latência do caminho mais longo em vez do número total de passos. Nos cenários de busca de informações na web ou de geração de código para interfaces densas, essa abordagem reduz o tempo de execução em 80% em comparação com um agente único. Para um desenvolvedor, isso significa que o Kimi pode, em um único comando, lançar um agente "Buscador de documentação", um agente "Gerador de API" e um agente "Redator de testes", e depois sintetizar seus respectivos trabalhos sem intervenção humana.
A codificação por visão (Coding with Vision)
O Kimi K2.5 também se destaca pelo seu treinamento multimodal nativo em 15 trilhões de tokens mistos texto-visão. Essa capacidade permite fluxos de trabalho revolucionários:
- Reconstrução de sites web a partir de vídeos: Ao analisar a gravação de uma interface, o modelo pode reconstruir a estrutura CSS/HTML, as animações JavaScript e a lógica de navegação
- Debugging visual autônomo: O modelo pode "olhar" uma captura de tela de um bug de UI, consultar a documentação do framework em questão e iterar sobre o código até que a renderização visual esteja conforme às expectativas.
- Tradução estética para código: Uma demonstração notável mostrou o Kimi K2.5 traduzindo a estética do quadro "La Danse" de Matisse em uma interface web funcional, provando uma compreensão profunda de estilo, cores e layout espacial.
Análise comparativa dos desempenhos agênticos
A avaliação de desempenho no início de 2026 se apoia em benchmarks que simulam a atividade real de um engenheiro em um ambiente de terminal e repositório complexo.
SWE-bench Verified e Pro: A realidade da produção
O SWE-bench Verified tornou-se o teste de referência para medir a capacidade de um modelo em resolver issues reais do GitHub em repositórios com mais de 10.000 linhas. O Claude Opus 4.6 mantém uma posição de liderança com 81,4%, embora o aumento em relação à versão 4.5 seja marginal, evidenciando uma estabilização da precisão em favor da confiabilidade arquitetural.
Uma descoberta importante de 2026 é a queda drástica das pontuações no SWE-bench Pro, um conjunto de dados mais recente e protegido contra contaminação. Os modelos que exibem mais de 70% na versão Verified frequentemente caem para cerca de 23% na versão Pro, o que demonstra que a resolução autônoma de problemas inéditos continua sendo o desafio supremo para as IAs de ponta.
Terminal-Bench 2.0: A interação com o sistema
O Terminal-Bench 2.0 avalia a capacidade do modelo em navegar em um sistema de arquivos, utilizar compiladores e interpretar saídas de logs para corrigir erros de sistema. O GPT-5.3 Codex domina atualmente esse segmento com 77,3%, enquanto o Claude Opus 4.6 se mantém em 65,4%. A análise sugere que o Claude é mais "prudente" e "reflexivo", o que pode atrasá-lo em workflows de comandos rápidos onde o Codex age como um puro operador de terminal.
O Qwen 3 e o Kimi K2.5 apresentam pontuações respectivas de 37,5% e 50,8%. Embora inferiores em valor absoluto, esses modelos são considerados pelos profissionais como sendo "amplamente suficientes" para 90% das tarefas de automação DevOps corriqueiras, tornando sua adoção atrativa por razões econômicas.
Integração no AWS Bedrock e Arquitetura MCP
Para uma organização que padroniza sua infraestrutura na AWS, o Bedrock oferece um quadro de governança e segurança que as chamadas de API diretas aos laboratórios não podem igualar.
Modelos serverless vs Bedrock Marketplace
A oferta de assistência ao código no Bedrock se divide em duas categorias de acesso:
- Foundation Models (FM) gerenciados: O Claude Opus 4.6 e a suíte Qwen 3 estão disponíveis em modo serverless com faturamento por token. Eles se beneficiam do isolamento de dados da AWS, garantindo que o código da empresa nunca seja utilizado para o treinamento dos modelos.
- Bedrock Marketplace: Modelos como o Kimi K2.5 podem ser implantados via o Marketplace em instâncias gerenciadas pelo usuário (Provisioned Throughput). Isso permite um controle total sobre as políticas de auto-scaling e a escolha dos tipos de instância.
O papel central do Model Context Protocol (MCP)
O protocolo MCP tornou-se o adaptador universal conectando os modelos aos sistemas de dados reais. No Bedrock, a arquitetura recomendada utiliza um cliente MCP integrado aos agentes Bedrock, comunicando-se com servidores MCP hospedados no AWS Lambda.
A AWS agora oferece servidores MCP especializados para:
- AWS IAM: Permite que os agentes consultem as políticas e configurações de segurança em modo somente leitura para auditoria ou troubleshooting.
- AWS Cloud Control API: Autoriza os agentes a criar, atualizar ou excluir recursos AWS via instruções em linguagem natural.
- S3 & Knowledge Bases: Conecta os modelos aos repositórios de documentação interna para reduzir alucinações técnicas.
Essa arquitetura permite transformar o Claude, o Qwen ou o Kimi de uma inteligência "isolada" em um motor de execução capaz de interagir diretamente com a nuvem da empresa.
Confronto das ferramentas de orquestração: Claude Code vs AWS Kiro
A escolha do modelo não pode ser dissociada da ferramenta que o orquestra. Duas filosofias se enfrentam no início de 2026: a potência bruta contra a disciplina arquitetural.
Claude Code: A autonomia radical
O Claude Code é projetado como um "invólucro extremamente fino" em torno da potência bruta do Claude Opus 4.6. Ele funciona diretamente no terminal, lê os arquivos, executa comandos shell e gerencia os fluxos Git de maneira autônoma até que a tarefa esteja concluída. É a ferramenta predileta dos desenvolvedores seniores que desejam delegar partes inteiras do desenvolvimento e confiam no modelo para gerenciar a complexidade sem supervisão constante.
No entanto, o Claude Code pode ser custoso em consumo de tokens, especialmente durante sessões prolongadas em grandes repositórios, pois tende a ser verboso em seu processo de raciocínio interno.
AWS Kiro: O desenvolvimento orientado por especificações
O AWS Kiro adota uma abordagem radicalmente oposta: ele impõe um workflow estruturado "Requirements → Design → Tasks". Quando um desenvolvedor solicita uma funcionalidade, o Kiro gera primeiro três documentos Markdown que o humano deve validar:
- requirements.md: Histórias de usuário e critérios de aceitação.
- design.md: Arquitetura técnica e definições de interfaces.
- tasks.md: Lista das etapas de implementação rastreáveis.
Essa abordagem, cientificamente embasada por pesquisas de 2025 mostrando que uma separação clara entre concepção e implementação reduz a taxa de alucinação em 37%, age como uma "estrela polar" impedindo a IA de se perder em detalhes de implementação errôneos.

Análise econômica e eficiência operacional
O custo de operação (TCO) de uma IA de assistência tornou-se uma preocupação central para os diretores técnicos em 2026. A transição para modelos Mixture-of-Experts transformou a curva de preços.
Custo por token e economias de escala
A Anthropic mantém uma precificação premium para o Opus 4.6, justificada por suas capacidades de raciocínio excepcionais. No entanto, o surgimento do Qwen 3 Coder no Bedrock introduziu uma pressão deflacionária massiva.
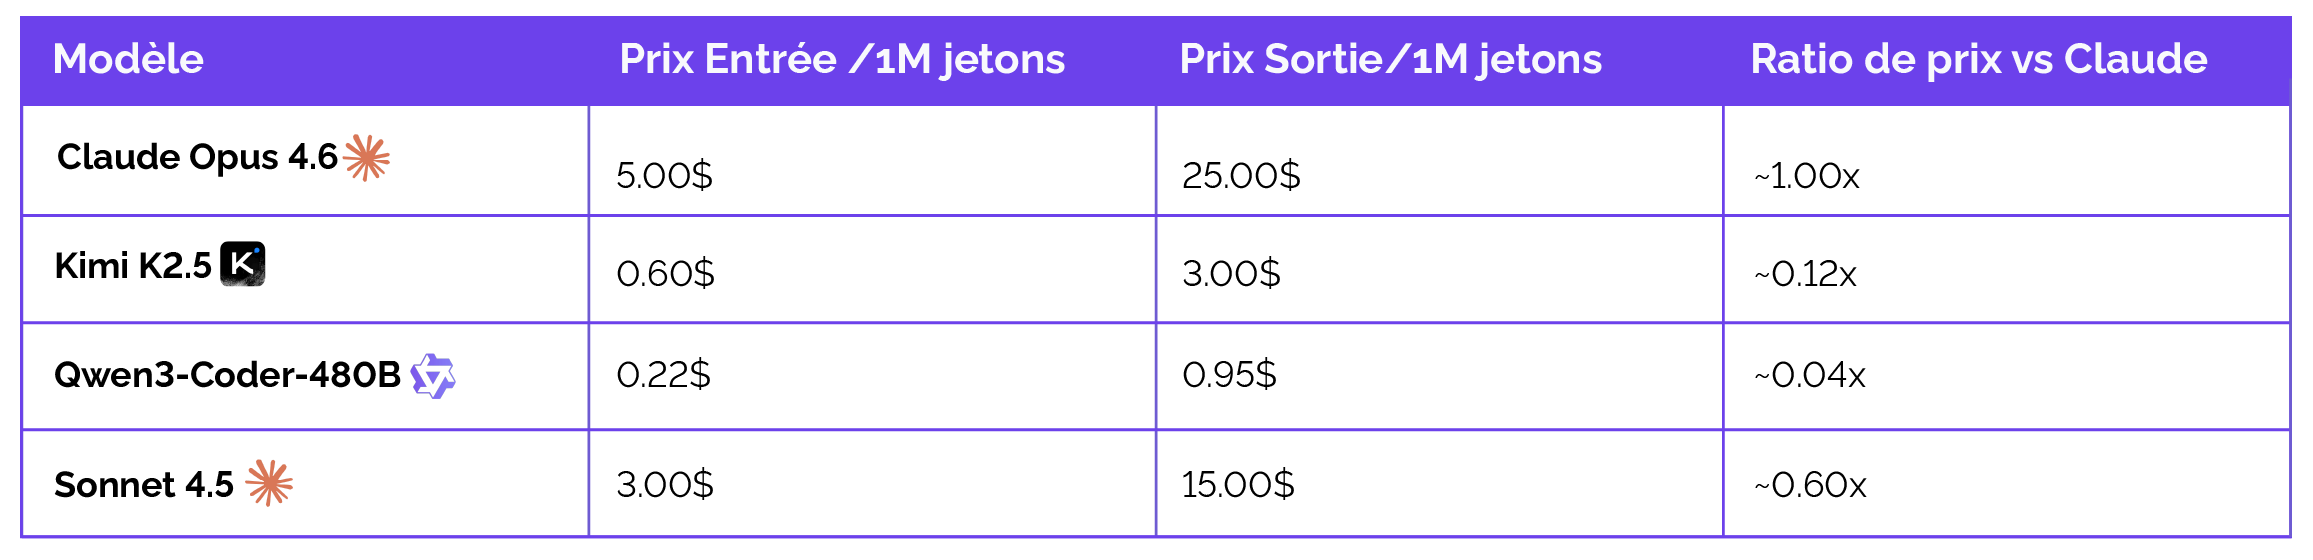
A diferença de preço de 83 vezes entre o Qwen3-Coder e o Claude Opus não é apenas um número; é uma mudança de paradigma operacional. Para tarefas de fundo como a geração de documentação técnica ou a migração automática de testes para novos frameworks, o custo do Claude pode se tornar proibitivo em repositórios com centenas de milhares de arquivos. Inversamente, o Qwen 3 permite "prototipar livremente" sem temer uma explosão da fatura cloud.
Desempenho real vs "Benchmaxxing"
Uma crítica recorrente nos fóruns de desenvolvedores no início de 2026 é o fenômeno de "benchmaxxing", onde os modelos chineses são suspeitos de serem excessivamente otimizados para brilhar nos benchmarks públicos em detrimento da utilidade real.
Os relatos de experiência indicam que, embora o Kimi K2.5 e o Qwen 3 sejam capazes de superar o Claude no papel, eles apresentam lacunas em produção:
- Confiabilidade "One-shot": O Claude Opus 4.6 frequentemente obtém sucesso em tarefas complexas logo na primeira tentativa, enquanto o Qwen 3 costuma exigir uma ou duas iterações adicionais para corrigir erros menores de sintaxe ou importações faltantes.
- Latência de reflexão: O Kimi K2.5, devido ao seu imenso pool de parâmetros, pode ser "dolorosamente lento", levando às vezes 20 minutos para gerar uma aplicação que o Claude conclui em 3 minutos.
- Coerência multi-turnos: Em conversas que se estendem por várias horas, o Qwen 3 "perde às vezes o fio" da arquitetura global, enquanto o sistema de compactação do Claude mantém uma integridade conceitual superior.
Os desafios de soberania e confidencialidade dos dados
A origem geográfica dos modelos levanta questões de conformidade regulatória importantes.
A restrição chinesa e as soluções AWS
Para muitas empresas ocidentais, o envio de código proprietário para endpoints localizados na China é uma proibição estrita por razões de conformidade SOC 2 ou HIPAA. O Bedrock resolve esse problema hospedando os pesos dos modelos Qwen e Kimi em servidores AWS na Europa ou nos Estados Unidos, garantindo que os dados nunca deixem o perímetro de segurança da infraestrutura da Amazon.
A alternativa local com Qwen3-Coder-Next
Para projetos que exigem confidencialidade absoluta ou uso offline, o Qwen3-Coder-Next representa um avanço significativo. Graças à sua arquitetura MoE ultraleve (3B ativos), esse modelo pode ser executado localmente em um MacBook Pro ou uma estação de trabalho equipada com uma única RTX 4090 a uma velocidade de 30-40 tokens por segundo. Essa "soberania local" permite que os desenvolvedores trabalhem com segredos industriais ou chaves de API sensíveis sem que nenhum token saia de sua máquina física.
Síntese técnica e recomendações estratégicas
A análise do estado da arte em 8 de fevereiro de 2026 mostra que o mercado está agora dividido em duas categorias: os modelos "Arquitetos" e os modelos "Operários de massa".
Claude Opus 4.6 permanece como a escolha incontestável para tarefas críticas que necessitam de precisão arquitetural absoluta e gestão de contexto gigante. Sua capacidade de entregar código "pronto para produção" logo na primeira versão minimiza o custo oculto da revisão de código por humanos.
Qwen 3 e Kimi K2.5 não são "ilusões"; eles trazem capacidades únicas que o Claude ainda não possui, notadamente a orquestração massiva em enxame (Kimi) e a eficiência linear para repositórios gigantes (Qwen).
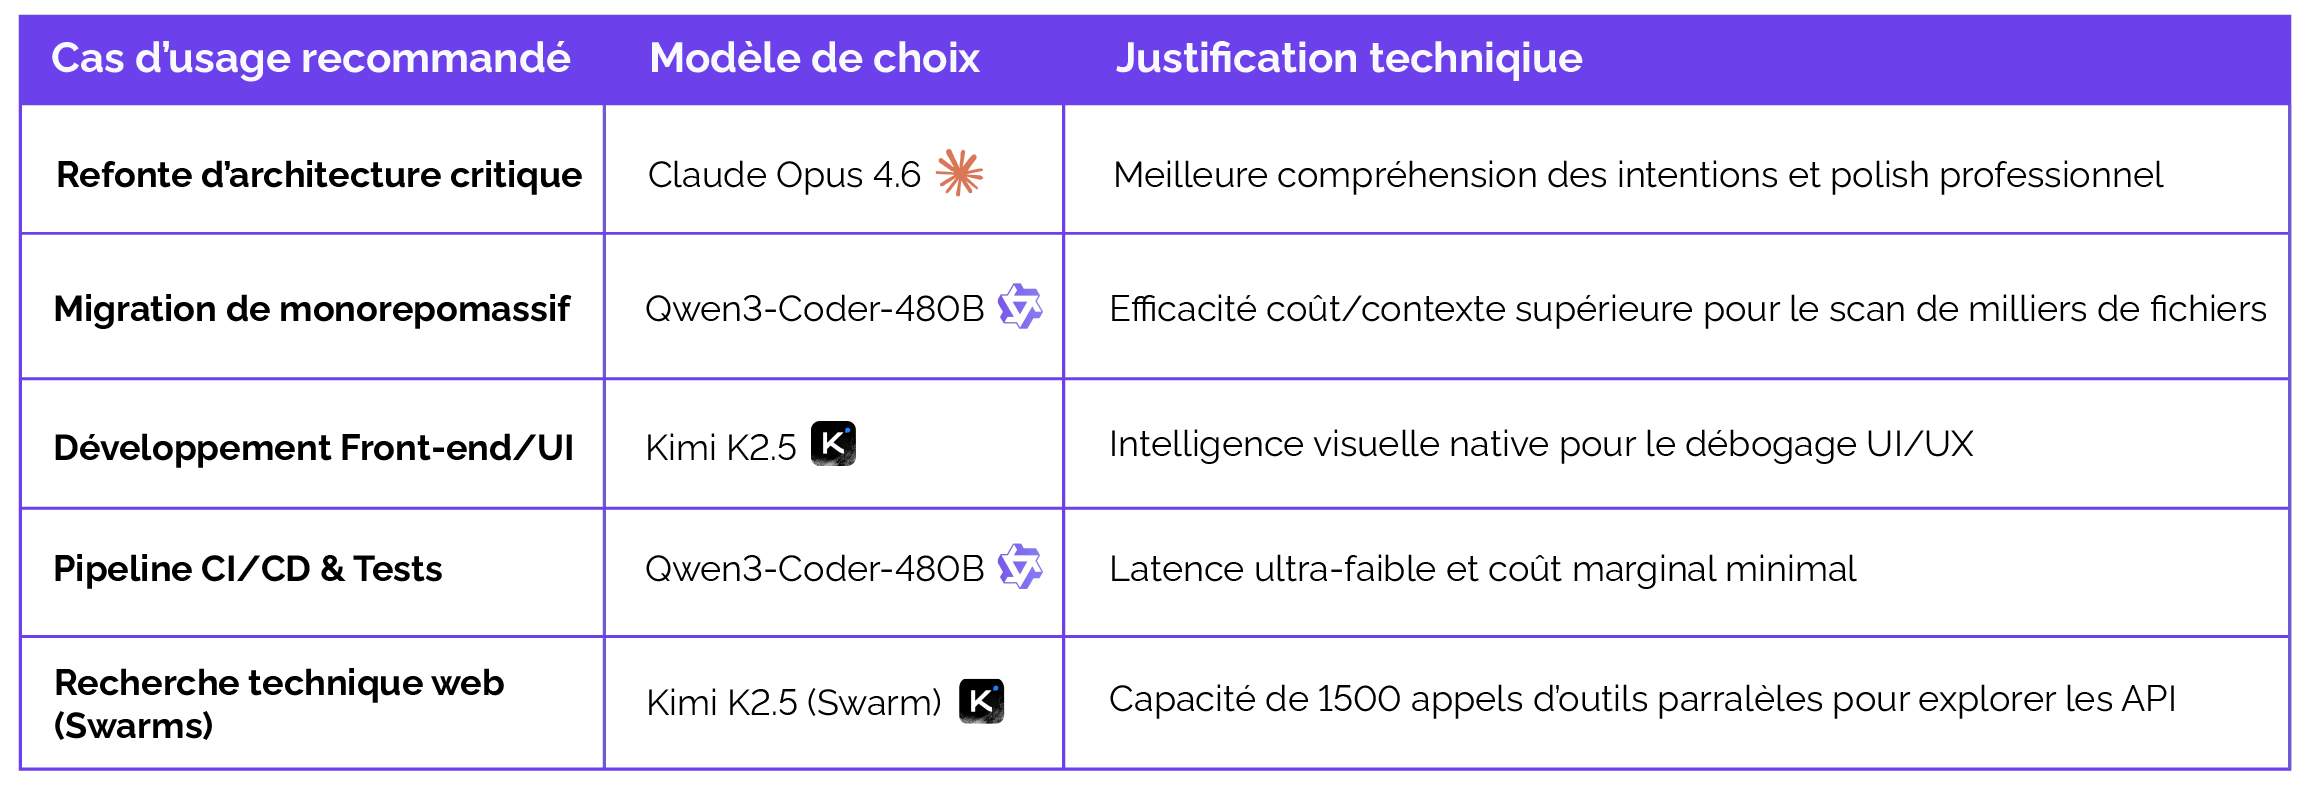
Para o CTO de uma organização tecnológica moderna, a estratégia vencedora em 2026 consiste em uma abordagem multi-modelo orquestrada no AWS Bedrock. Utilizar o Claude Opus 4.6 via Claude Code ou AWS Kiro para a fase de concepção e as revisões de código críticas, enquanto delega a implementação de rotina, a documentação e os testes unitários a modelos como o Qwen 3 ou o Kimi K2.5, permite maximizar a velocidade controlando os custos. A integração dessas ferramentas via o protocolo MCP garante que a IA não seja mais apenas um assistente de escrita, mas um membro pleno da equipe de engenharia, capaz de agir sobre a infraestrutura e manter a memória de longo prazo do projeto.
Em última análise, a dúvida sobre as capacidades do Qwen e do Kimi não é mais justificada à luz dos benchmarks de 2026. Embora ainda não substituam a "fineza cognitiva" do Claude, eles dominam os segmentos de eficiência em massa e inteligência visual, forçando uma reavaliação completa da maneira como os orçamentos de IA são alocados nas empresas de software.